Pesquisa das Pesquisas: Relatório N° 1
Análise descritiva sobre a série bruta de levantamentos registrados no TSE — as pesquisas como unidade de observação, não os eleitores. Sem microdados; leitura indicial, não inferência sobre o eleitorado.
25 pesquisas com 1º turno · 20 com 2º turno 27 registros TSE · 12 institutos janela jan–ago 2026 base = total de entrevistados
fonte: matéria c/ metodologia (ainda não reconciliada contra a íntegra do PesqEle)
§1 · Intenção de voto por data de campo, instituto e candidato
01 Série bruta e tendência descritiva
O objeto é a dispersão completa dos levantamentos, não uma estimativa agregada única. Cada ponto é uma pesquisa; a cor distingue os candidatos e a forma, o método de coleta. A linha é uma suavização LOESS descritiva — não previsão nem agregador corrigido.
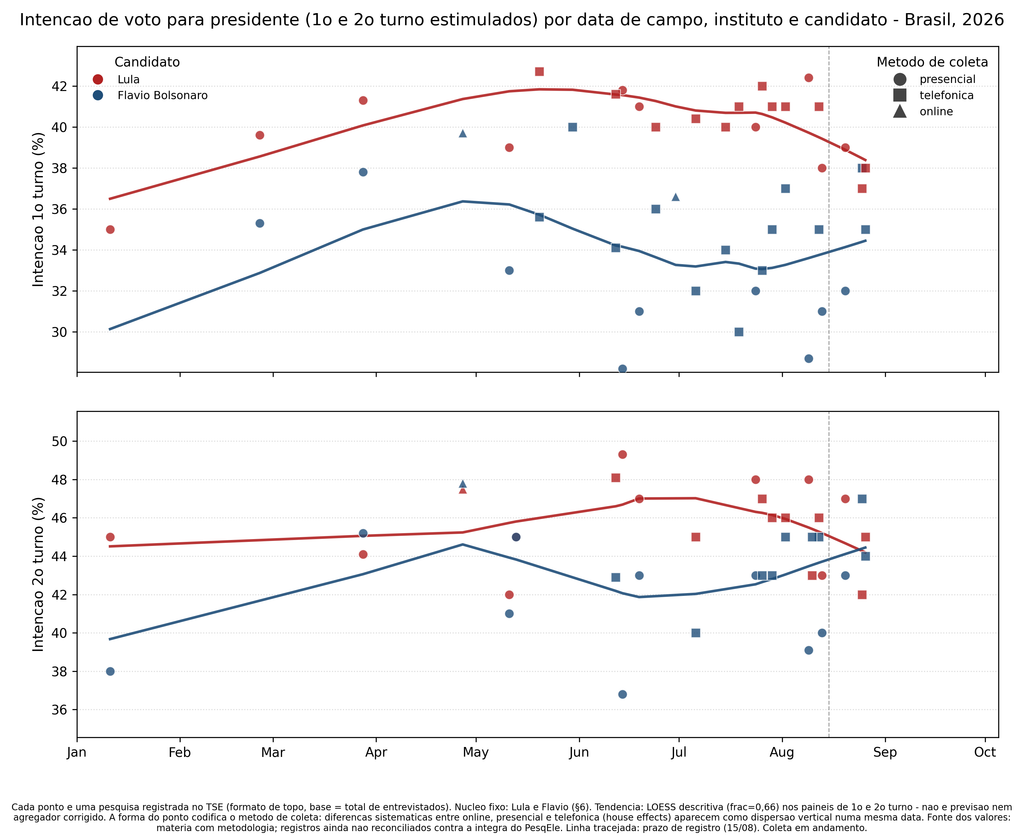
Núcleo fixo (Lula e Flávio; §6 do protocolo). A dispersão vertical entre institutos numa mesma data é o dado, não ruído. Diferenças dentro da margem de erro não sustentam ordenamento entre candidatos.
No 1º turno, a curva de Lula sobe de cerca de 35% em janeiro para um platô na casa dos 40–41%; a de Flávio sobe até 35–37% e as rodadas mais recentes de agosto estreitam a distância — a PoderData de 23–26/08 (38% a 35%) registra a menor diferença desde maio, e a Gerp de 21–25/08 chega a pôr Flávio numericamente à frente no 1º turno (38% a 37%), sempre dentro da margem. Os pontos online da AtlasIntel (triângulos) seguem acima da nuvem presencial e telefônica — objeto da seção seguinte.
§2 · Desvio sistemático por instituto e método de coleta
02 Efeitos de casa (house effects)
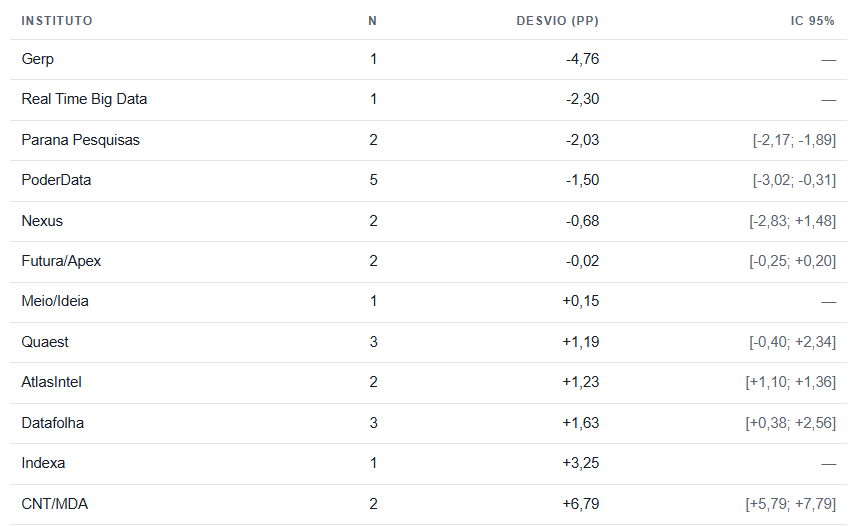
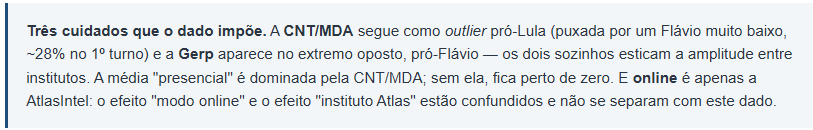
Para cada pesquisa calculou-se a vantagem de Lula sobre Flávio no 1º turno (o gap) e o seu desvio em relação à tendência temporal comum (LOESS). A média desses desvios por grupo mede o viés sistemático: positivo = gap mais largo que o consenso na data (relativamente pró-Lula); negativo = mais estreito (relativamente pró-Flávio).
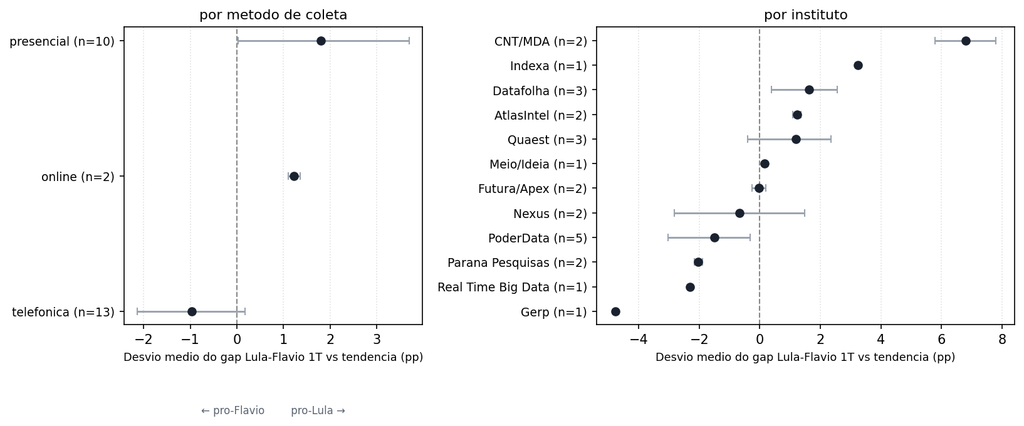
Ponto = desvio médio do gap de 1º turno (pp); barras = intervalo de 95% por bootstrap sobre as pesquisas. Institutos com n=1 não têm incerteza estimável.
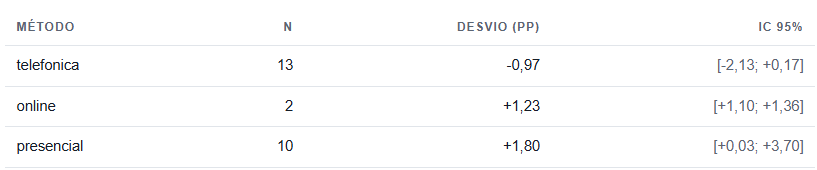
Por método, as telefônicas pendem levemente pró-Flávio (-0,97 pp) e as presenciais pró-Lula (+1,80 pp); os intervalos, porém, quase tocam o zero. O sinal existe, mas é fraco e não sustenta ordenamento forte entre modos.
§3 · Dispersão entre institutos por janela mensal
03 Dispersão inter-institutos ao longo do tempo
Se os institutos convergissem à medida que a eleição se aproxima (herding), o desvio-padrão do gap de 1º turno entre pesquisas de um mesmo mês deveria encolher com o tempo. Não é o que se observa.
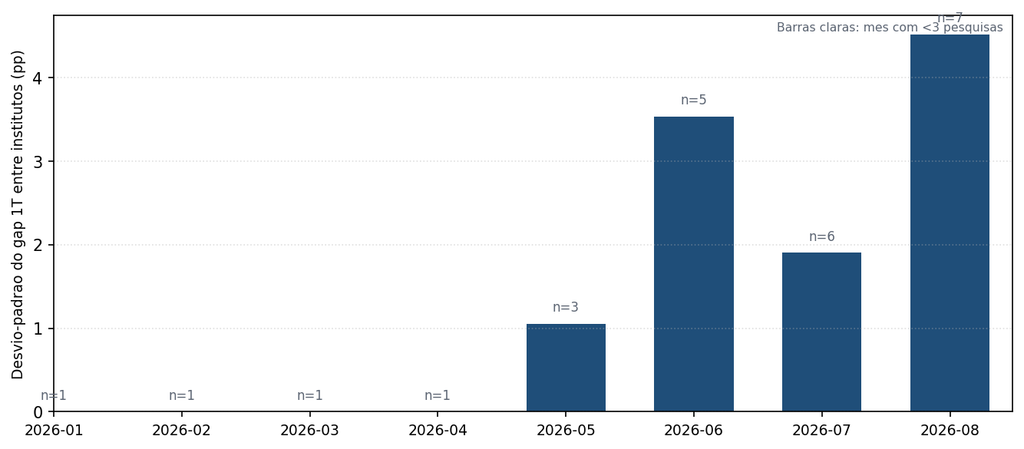
Desvio-padrão do gap de 1º turno entre institutos, por mês de fim de campo. Barras claras: meses com menos de 3 pesquisas, em que a medida é frágil ou indefinida.
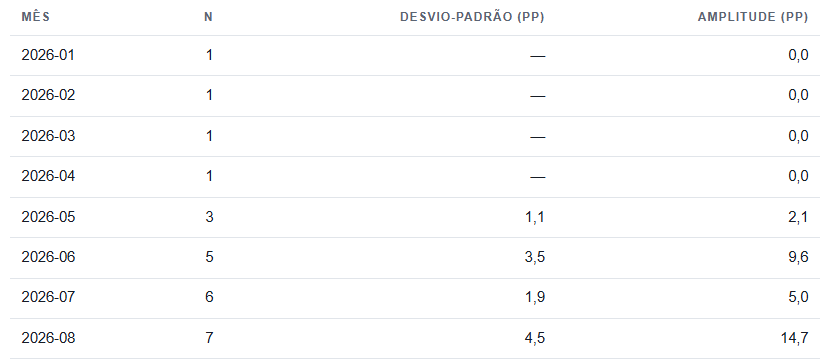
A dispersão é substancial e não-monotônica e, com as pesquisas de agosto (n=7), atinge a maior amplitude da série: 14,7 pp entre institutos na mesma janela mensal. Não há indício de convergência — o que, longe de ser um defeito, é precisamente o achado que a série bruta existe para tornar visível. Boa parte da amplitude vem da heterogeneidade já identificada (CNT/MDA num extremo, Gerp e telefônicas no outro).
§4 · Distância entre candidatos por turno
04 Vantagem de Lula sobre Flávio por turno
A vantagem média de Lula é de 7,0 pp no 1º turno e de 2,9 pp no 2º. Restringindo às 18 pesquisas que trazem os dois cenários, o contraste se mantém: 7,1 pp no 1º contra 3,3 pp no 2º.
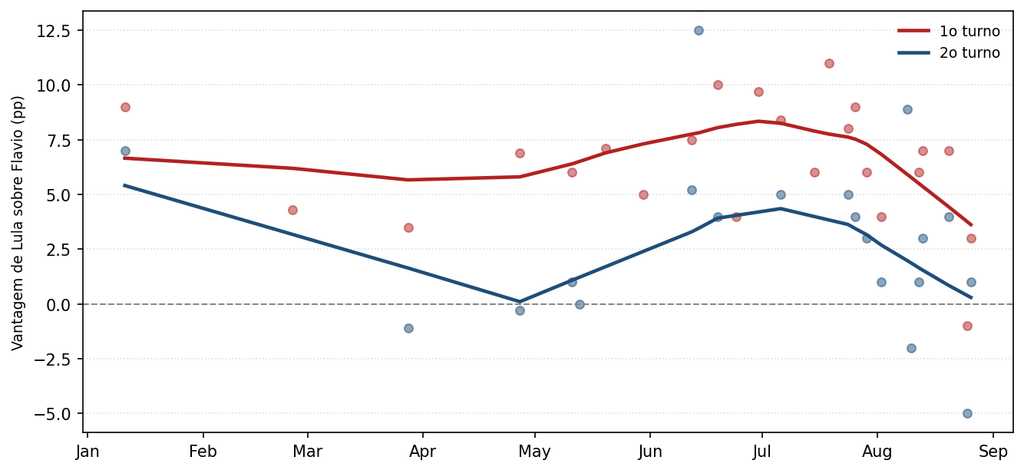
Vantagem de Lula sobre Flávio (pp) por data de campo, com suavização LOESS por turno. Valores acima de zero indicam Lula à frente.
O runoff reduz a dianteira do 1º turno a menos da metade, e em 4 das 20 simulações de 2º turno Flávio aparece numericamente à frente (Paraná em março, Gerp e AtlasIntel) — em geral dentro da margem. É a leitura agregada de transferência e consolidação de voto; nada aqui autoriza afirmar movimento de opinião a partir de diferenças que cabem no arredondamento.
§5 · Limites do dado e próximos passos
05 Alcance e limites do dado
Todos os valores são agregados de topo, tal como publicados; não há microdados. Logo, nada no nível do eleitor — sem recorte por segmento, sem modelo de escolha de voto, sem medida individual de polarização. Para isso, o caminho segue sendo ESEB, LAPOP e “A Cara da Democracia”, com esta série como pano de fundo agregado.
Outros limites: com 27 pesquisas, os efeitos por instituto são ruidosos (daí a preferência pelo agrupamento por método e pelos intervalos de bootstrap); o arredondamento embute ±0,5 pp antes da margem, de modo que oscilações de 1 pp podem ser só arredondamento; a rejeição foi retirada da figura por não ser comparável entre institutos; e nenhum ponto foi ainda reconciliado contra a íntegra do PesqEle — a fonte é matéria com metodologia.
Próximos passos de maior retorno: (i) reconciliação contra as íntegras do PesqEle, virando fonte_valor de “matéria” para “íntegra”; (ii) sobreposição do benchmark modelado (PollingData/El-Dash) para dimensionar a magnitude das correções agregadas; (iii) coleta das rodadas intermediárias faltantes para adensar as células por instituto.