Pesquisa das Pesquisas: Relatório Nº 5

Uma leitura do conjunto das pesquisas registradas no TSE, tomando cada levantamento — e não o eleitor — como unidade de observação. O detalhamento técnico está reunido na nota metodológica ao final.
79 pesquisas com 1º turno · 74 com 2º turno 81 registros no TSE · 18 institutos
janela jan–set 2026 (campo até 01/10)
fonte: matéria com metodologia, com registro no TSE conferido
§1 · Intenção de voto por data de campo, instituto e candidato
01 Série bruta e tendência
Em vez de uma média única, o gráfico mostra todas as pesquisas lado a lado no tempo. Cada ponto é um levantamento; a cor separa os candidatos e o formato do ponto indica como a pesquisa foi feita — presencial, por telefone ou pela internet. A linha grossa é apenas um resumo visual da tendência de cada candidato, não uma previsão.
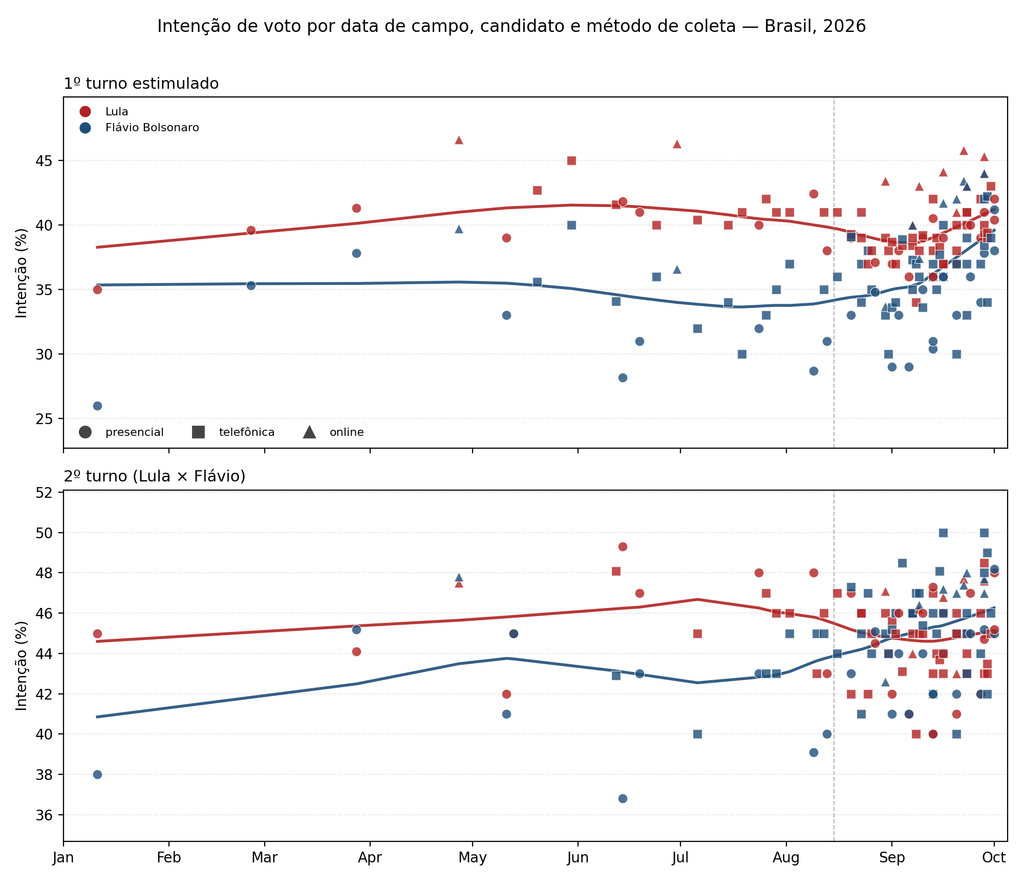
Com o início da campanha no rádio e na TV, o número de pesquisas disparou: só entre meados de agosto e o 1º turno foram divulgadas mais de sessenta pesquisas, de dezoito institutos. No primeiro turno, Lula oscila na casa dos 39–45% na reta final, enquanto Flávio Bolsonaro aparece entre 34% e 42% — e vários institutos já o colocam numericamente à frente, sempre por margens estreitas. O crescimento de Augusto Cury (para cerca de 8% a 12%) é a novidade do período. A distância entre os dois principais nomes se estreita, mas quem aparece na frente depende, em boa medida, de qual instituto publicou a pesquisa — o tema da seção seguinte.
§2 · Desvio sistemático por instituto e método de coleta
02 Efeitos de casa (house effects)
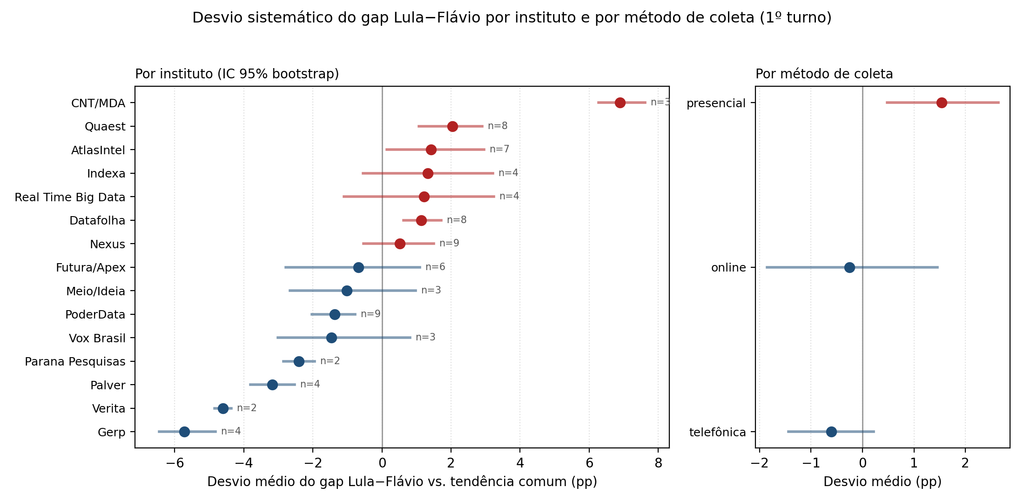
Institutos diferentes tendem a produzir resultados sistematicamente distintos — não por erro, mas por diferenças de método e de público alcançado. É o chamado “efeito de casa”. Para enxergá-lo, compara-se cada pesquisa com a tendência do conjunto naquele momento: quem fica acima favorece relativamente Lula; quem fica abaixo, Flávio. O valor é medido em pontos percentuais sobre a diferença entre os dois; a faixa entre colchetes é a incerteza dessa medida.
| Método | n | desvio (pp) | faixa de incerteza |
|---|---|---|---|
| presencial | 24 | +1,54 | [+0,48; +2,64] |
| online | 11 | -0,25 | [-1,85; +1,46] |
| telefônica | 44 | -0,60 | [-1,44; +0,22] |
Por método de coleta, o padrão é claro, ainda que discreto: as pesquisas por telefone tendem a favorecer Flávio (-0,60 ponto), e as presenciais, Lula (+1,54 ponto); as feitas pela internet também pendem para Lula (-0,25 ponto). As faixas de incerteza, porém, quase encostam no zero — o sinal existe, mas é fraco e não autoriza dizer que um método “erra” para um lado.
| Instituto | n | desvio (pp) | faixa de incerteza |
|---|---|---|---|
| CNT/MDA | 3 | +6,90 | [+6,27; +7,62] |
| American Analytics | 1 | +5,13 | — |
| Alfa Inteligencia | 1 | +4,32 | — |
| Quaest | 8 | +2,04 | [+1,07; +2,91] |
| AtlasIntel | 7 | +1,42 | [+0,14; +2,96] |
| Indexa | 4 | +1,33 | [-0,55; +3,21] |
| Real Time Big Data | 4 | +1,22 | [-1,10; +3,24] |
| Datafolha | 8 | +1,14 | [+0,62; +1,71] |
| DataTrends | 1 | +0,75 | — |
| Nexus | 9 | +0,52 | [-0,53; +1,51] |
| Futura/Apex | 6 | -0,68 | [-2,78; +1,09] |
| Meio/Ideia | 3 | -1,02 | [-2,66; +0,98] |
| PoderData | 9 | -1,37 | [-2,03; -0,77] |
| Vox Brasil | 3 | -1,46 | [-3,01; +0,81] |
| Parana Pesquisas | 2 | -2,40 | [-2,86; -1,95] |
| Palver | 4 | -3,17 | [-3,81; -2,53] |
| Verita | 2 | -4,60 | [-4,84; -4,37] |
| Gerp | 4 | -5,72 | [-6,45; -4,82] |
O que ler nesta tabela. Nos extremos estão a CNT/MDA, que puxa para Lula (por medir um Flávio muito baixo, perto de 28% no primeiro turno), e a Gerp e a Veritá, que puxam para Flávio. São esses poucos institutos que esticam a distância entre os resultados. A leitura correta não é “tal instituto está errado”, e sim que a ordem entre os candidatos numa dada semana depende de quem publicou naquela semana. Uma verificação independente desses desvios, por um método estatístico distinto, aparece na seção 5.
§3 · Dispersão entre institutos por janela mensal
03 Convergência entre institutos
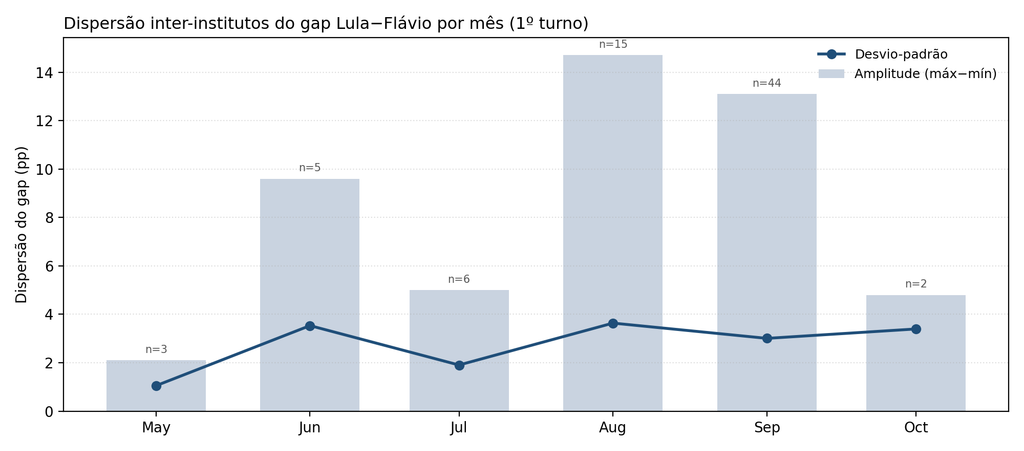
Seria natural esperar que, com a eleição se aproximando, as pesquisas fossem ficando mais parecidas entre si. Não é o que se observa: a distância entre o maior e o menor resultado de cada mês permanece alta.
| Mês | n | dispersão (pp) | amplitude (pp) |
|---|---|---|---|
| 2026-01 | 1 | — | 0,0 |
| 2026-02 | 1 | — | 0,0 |
| 2026-03 | 1 | — | 0,0 |
| 2026-04 | 1 | — | 0,0 |
| 2026-05 | 3 | 1,1 | 2,1 |
| 2026-06 | 5 | 3,5 | 9,6 |
| 2026-07 | 6 | 1,9 | 5,0 |
| 2026-08 | 15 | 3,6 | 14,7 |
| 2026-09 | 44 | 3,0 | 13,1 |
| 2026-10 | 2 | 3,4 | 4,8 |
A dispersão é grande e não diminui de forma constante. Agosto concentra a maior amplitude de toda a série — 14,7 pontos entre o instituto mais favorável e o menos favorável a Lula numa mesma janela — e setembro mantém 4,8 pontos, já com a série reunindo 18 institutos. Boa parte dessa distância vem dos poucos institutos que aparecem nos extremos da seção anterior.
§4 · Distância entre candidatos por turno
04 Trajetória da diferença entre candidatos
A dianteira de Lula é maior no primeiro turno do que num eventual segundo turno. Na média das pesquisas, ela passa de 4,4 pontos no primeiro turno para 0,4 pontos no segundo.
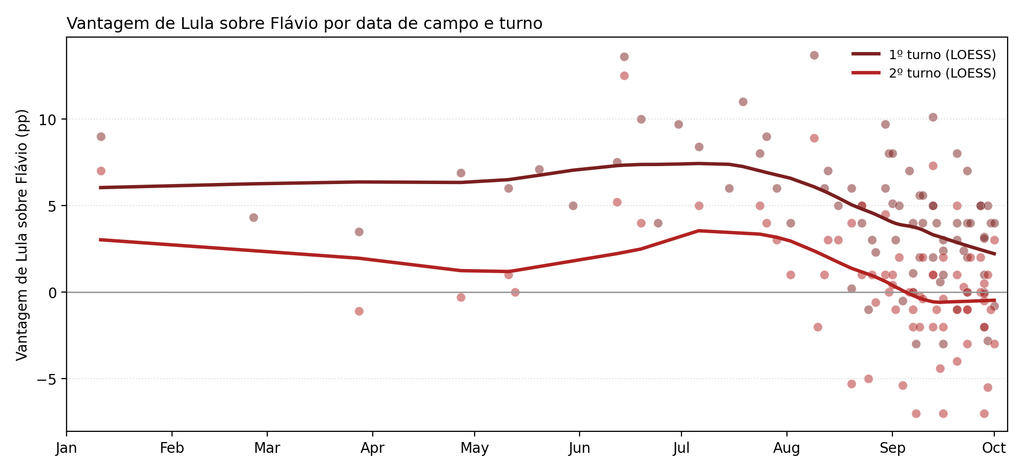
Quando o cenário se fecha em apenas dois nomes, Flávio recebe proporcionalmente mais votos dos demais candidatos, e a dianteira de Lula praticamente desaparece — a média fica abaixo de um ponto. Em 32 das 74 simulações de segundo turno Flávio chega a aparecer numericamente à frente (com outras 6 em empate exato), quase sempre dentro da margem de erro. É uma leitura de como os votos tendem a se transferir — não uma medida de humor ou de emoção do eleitorado, que este tipo de dado não capta.
§5 · Uma referência modelada e a checagem dos efeitos de casa
05 Agregador e efeitos de casa
Esta série é, por opção, “crua”: mostra a dispersão em vez de escondê-la numa média. A título de comparação, sobrepõe-se a ela uma estimativa de tipo diferente — um agregador, que faz o oposto: combina todas as pesquisas numa única trajetória, com uma faixa de incerteza. Ela foi produzida com uma ferramenta de código aberto (o pacote agregR) a partir da mesma base de pesquisas, e serve apenas de referência; os detalhes do modelo estão na nota metodológica.
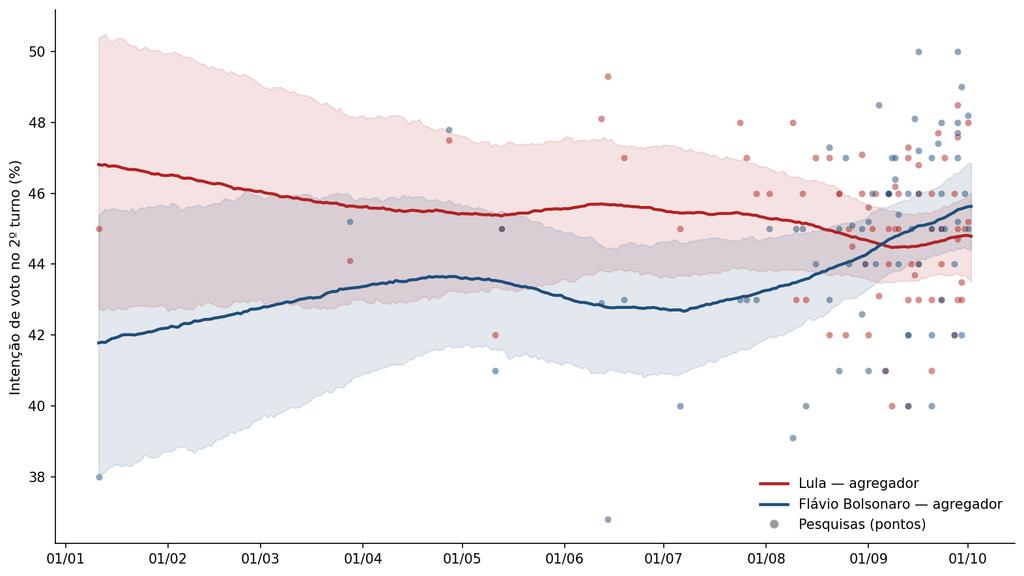
Na data mais recente, a estimativa agregada de segundo turno, já corrigida para os efeitos de casa, dá 44,8% para Lula e 45,6% para Flávio — um empate técnico, com Flávio numericamente à frente por menos de um ponto. Sem a correção, a mesma conta daria Lula 45,5% e Flávio 46,2%: nesta rodada, ao contrário do que se via em meados de setembro, o ajuste quase não desloca o resultado, porque as casas que puxam para cada lado acabam se equilibrando no conjunto recente. Vale a ressalva de sempre: este número é uma referência externa; não substitui a série de pesquisas nem é tratado como o resultado “verdadeiro”.
O mesmo modelo permite conferir, por um caminho estatístico independente, os efeitos de casa da seção 2. O gráfico abaixo põe lado a lado as duas medidas para cada instituto.
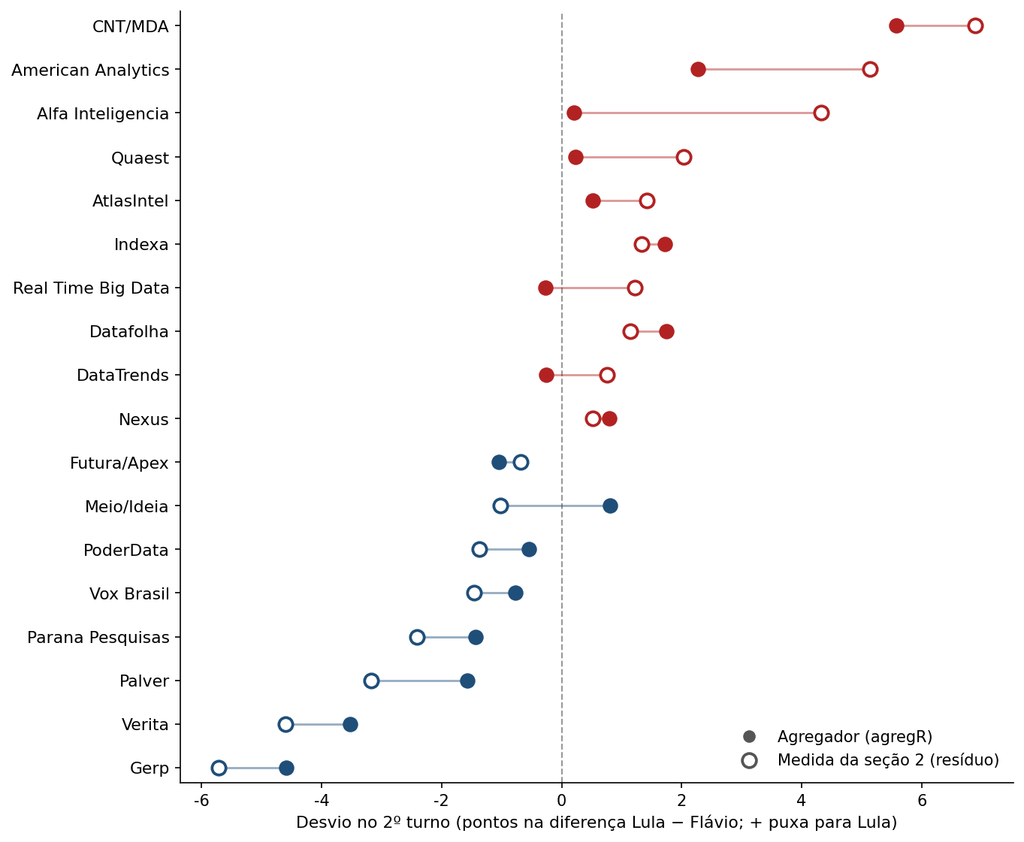
Mesma ordem, intensidade menor. Os dois métodos concordam sobre quem puxa para cada lado — Gerp e Veritá para Flávio, CNT/MDA para Lula. Diferem na intensidade: o modelo agregador é mais cauteloso e comprime os casos extremos (a CNT/MDA, por exemplo, cai de cerca de 7 para 5 pontos de desvio). O encolhimento é maior para os institutos que aparecem uma única vez, cujo desvio o modelo trata com mais reserva. A conclusão prática é que a seção 2 acerta a ordem dos efeitos de casa, mas tende a exagerar seu tamanho nos extremos — e deve ser lida assim.
§6 · Nota metodológica
06 Metodologia
O que entra. Cada ponto é uma pesquisa de intenção de voto para presidente, de âmbito nacional, registrada no Tribunal Superior Eleitoral. Usam-se os percentuais tal como publicados (os chamados valores “de topo”), calculados sobre o total de entrevistados; nada é recalculado. São plotados apenas Lula e Flávio Bolsonaro — os dois nomes presentes em praticamente todas as pesquisas; os demais permanecem na base, fora do gráfico. Nos cenários de setembro testados com e sem Pablo Marçal (cuja candidatura foi indeferida pelo TSE em 11/09), adota-se o cenário sem Marçal, por ser mais comparável ao restante da série.
A linha de tendência. A curva que resume cada candidato é uma suavização — uma espécie de média móvel flexível (tecnicamente, LOESS) que acompanha o miolo da nuvem de pontos. É descritiva: serve para ler o movimento geral, e não para prever resultado.
Efeitos de casa (seção 2). Para cada pesquisa calcula-se a diferença entre Lula e Flávio e o quanto ela se afasta da tendência do conjunto na mesma data; a média desses afastamentos, por instituto ou por método, é o efeito de casa. A faixa de incerteza vem de reamostragem (bootstrap): sorteiam-se repetidamente as pesquisas de cada grupo para ver o quanto a média varia. Por ser uma medida simples e feita instituto a instituto, ela capta bem a direção do viés, mas tende a exagerá-lo nos casos extremos — como mostra a comparação da seção 5.
Dispersão (seção 3). Para cada mês, mede-se a amplitude (diferença entre o maior e o menor valor da diferença Lula–Flávio) e uma dispersão típica (o desvio-padrão). Ambas indicam o grau de discordância entre institutos numa mesma janela de tempo.
Distância por turno (seção 4). Compara-se, na mesma pesquisa, a vantagem de Lula no primeiro e no segundo turno, e conta-se em quantas simulações de segundo turno cada candidato aparece à frente.
A referência modelada (seção 5). O agregador usado é o pacote aberto agregR, de Rafael N. Magalhães. Trata-se de um modelo estatístico que estima uma trajetória “verdadeira” por trás das pesquisas, separando o sinal do ruído e a assinatura de cada instituto (é um modelo bayesiano de espaço de estados, com nível, tendência e erros, estimado por simulação). A faixa mostrada é o intervalo dentro do qual a estimativa tem 90% de probabilidade de estar, segundo o modelo. Roda sobre a mesma base deste relatório. Uma opção do modelo — corrigir os institutos também pelo alinhamento político do candidato — foi mantida desligada, por ser justamente o tipo de ajuste que esta série prefere exibir a aplicar. Os números do modelo são referência e não integram a base de pesquisas.
Limites. Não há acesso aos microdados, apenas aos totais publicados; portanto, nada se pode dizer no nível do eleitor. Os percentuais são números inteiros arredondados, o que embute cerca de meio ponto de imprecisão antes mesmo da margem de erro; oscilações de um ponto entre pesquisas podem ser só arredondamento. A rejeição não é comparável entre institutos, porque cada um pergunta de um jeito, e por isso não entra nas figuras. Por fim, os valores foram conferidos em fonte primária (a ficha técnica de cada pesquisa), mas a checagem final contra a íntegra registrada no TSE ainda está pendente.
